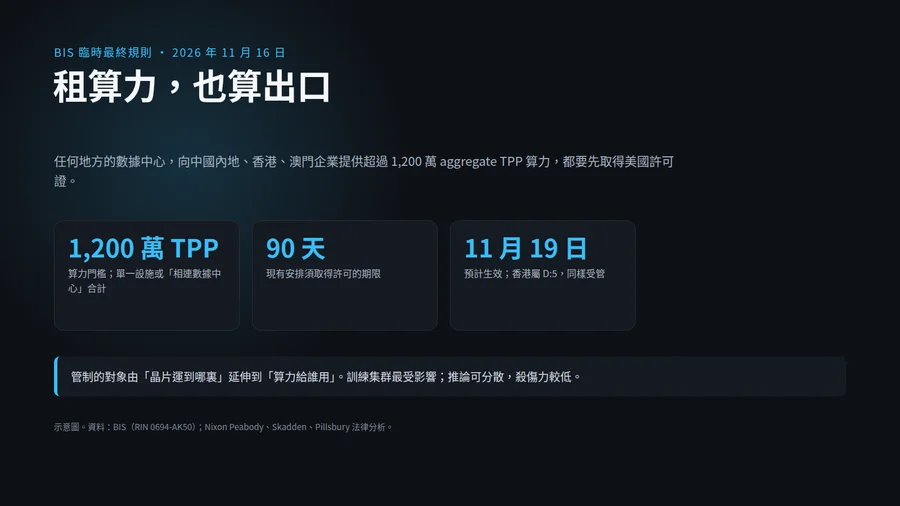
11 月 16 日,美國商務部工業與安全局(BIS)發布臨時最終規則,正式把「租算力」納入出口管制。任何地方的數據中心,只要向總部設於中國內地、香港、澳門或其他受限地區的企業,提供超過 1,200 萬「總處理性能」(aggregate TPP)的算力,出口、再出口或境內轉移相關先進芯片與伺服器,都要先取得美國許可證。規則預計 11 月 19 日在《聯邦公報》刊登並生效,現有安排有 90 天申請期。
這條規則堵塞一個存在多年的缺口:以往管制的是晶片「運到哪裏」,企業仍可把訓練工作丟到新加坡、馬來西亞數據中心,用遠程 API 或雲端虛擬機使用美國晶片。新規則管的是「算力給誰用」,等於把雲端算力視同芯片出口。
規則管甚麼:三個關鍵詞
第一,門檻是 1,200 萬 aggregate TPP,可按單一數據中心或「相連數據中心」合計,而「相連」包括數碼連接,不限於同一園區。第二,對象是總部或最終母公司在中國、D:5 國家或澳門的企業;香港屬 D:5,因此香港同樣受管制。第三,舉證責任在供應方:出口商要取得數據中心的客戶盡職審查數據,數據中心拒絕提供,即視為「已知」而觸發許可要求。
規則同時新增印尼、馬來西亞、新加坡、泰國、巴西五個「轉運風險」國家的許可要求,收緊晶圓廠與封裝廠的盡職審查,並正式撤銷拜登時代的「AI 擴散規則」。90 天內未取得許可的現有安排,日後可能面臨限制。
市場反應:不是全面崩跌,而是輪動
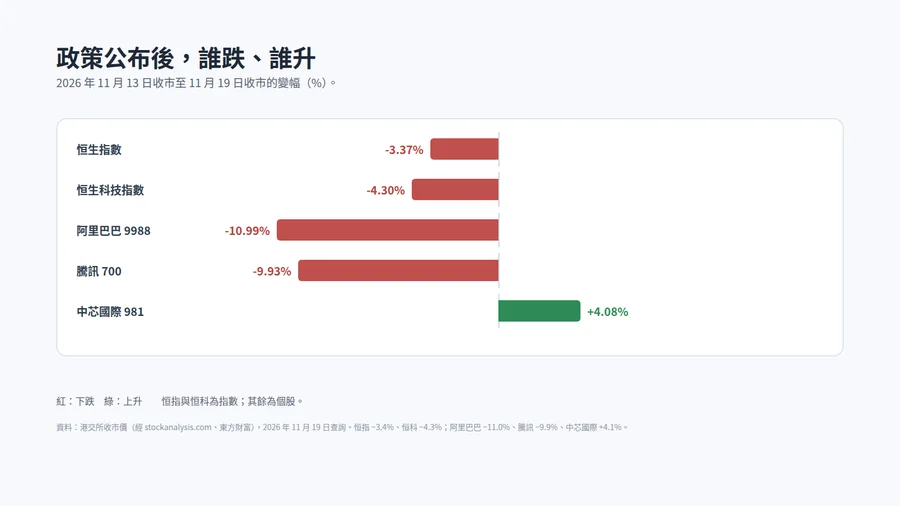
消息公布後,港股連跌兩日。恒生指數由 11 月 13 日收市 23,637.60 點,跌至 19 日 22,841.62 點,跌幅 3.4%;恒生科技指數由 3,813.19 點跌至 3,649.14 點,跌幅 4.3%。個股方面,由 90.55 港元跌至 80.60 港元(−11.0%),由 386.60 港元跌至 348.20 港元(−9.9%)。
但同一時間,芯片股上升:中芯國際由 48.52 港元升至 50.50 港元(+4.1%),、在 17 日更分別升近 8%。市場的定價很清楚:依賴海外算力做大模型的公司受損,被視為替代方案的國產芯片與代工廠受益。這不是單純的恐慌,而是對「算力從哪來」重新定價。
先分清:訓練與推論是兩件事
推論(Inference)是「用模型」:輸入一句話,模型輸出答案。推論可以分散、可以排隊、可以用較低階芯片,甚至可在手機或邊緣裝置運行。訓練是「打造模型」:用大量數據反覆調整數千億個參數,需要成千上萬張芯片同步運算數週至數月。
上述兩者對基建要求完全不同。訓練要求極高的互連頻寬與低延遲:一張芯片出錯或落後,整個集群都要等;一次訓練動輒數千步,任何不穩定都會拖長周期、耗費大量成本。推論可容忍較多中斷,也可用小模型蒸餾、量化來補救。這就是為何美國管制訓練算力,殺傷力遠大於管制推論。
CUDA:二十年挖出來的護城河
最深的護城河不是晶片本身,而是 CUDA。2006 年,Nvidia 發表 CUDA,把 GPU 由圖像處理器變成通用並行運算平台;2007 年 2 月正式推出。主導者是工程師 Ian Buck 與 John Nickolls——Buck 在史丹福博士期間開發 Brook 這個 GPU 編程語言,加入 Nvidia 後把它變成 CUDA。
二十年後,這筆長線投資的回報是:cuDNN、NCCL、TensorRT 等函式庫成為深度學習的默認底層,PyTorch、vLLM 等框架直接建在其上。開發人員要轉去對手晶片,不是換一張卡,而是要重寫大量低層軟件、重新調校、重新訓練工程團隊。 CUDA 生態是轉換成本的最大障礙,所以黃仁勳一直在維護開源軟件和供應商關係,就是要 CUDA 滴水不漏。
:買的不是網卡,是整座集群
如果 CUDA 解決「怎樣寫」,Mellanox 解決了「怎樣連」。Nvidia 在 2019 年 3 月宣布以 69 億美元收購 Mellanox,2020 年完成。這筆交易把 InfiniBand、Spectrum 以太網與 NVLink 相關技術納入了 Nvidia,同時賣芯片、交換機、網卡與整套集群設計。
Mellanox 回報驚人:Nvidia 網絡業務現時每季收入約 210 億美元,佔公司 1,158 億美元季度收入的 18%。訓練前沿模型,瓶頸往往是不在單卡算力,而在「幾萬張卡能否像一張卡那樣工作」,否則大部份卡在空轉;Mellanox 正是問題答案。這也是為何中國企業即使取得芯片,仍難以複製同等規模的訓練集群。
反方論點:AI 真的能複製 CUDA 嗎?
過去一年,最有力的反駁來自 ,聲稱 Claude Mythos 模型只用了約三天,就把一個模型移植到 AMD MI355X 上運行;以往同類工作要 6 至 12 個月。Anthropic 亦已把算力分散到多個供應商:包括 Google 算力承諾約 1,213 億美元、與 Amazon(Trainium)約 1,100 億美元,又與 AMD 簽下 2GW Instinct 部署、AMD 同時投資 50 億美元。
但要注意範圍:Anthropic 所謂三天成果是「其中一個模型的 prompt processing,達到可用水平」,不是完整訓練流程,也不是整個 CUDA 生態重寫。AI 可以加速移植、生成內核、調試效能,這是真實進展;但訓練技術棧(tech stack)穩定性、極端規模下的網絡調度、以及數以百萬計開發者的既有習慣,不是幾天可以搬走。
中國替代路徑:Ascend 有進展,但仍有不少距離
華為是中國最具體的答案。Ascend 950PR 於 2026 年第一季推出;以 950DT 為基礎的 Atlas 950 SuperPod 計劃 2026 年第四季登場,滿配 8,192 顆芯片、160 個機櫃。軟件方面,CANN 已開源,華為稱有超過 40 個模型在 Ascend 與 CANN 上原生預訓練。
但是差距仍然很大。DeepSeek 研究人員引述的數據,Ascend 910C 的效能約為 Nvidia H100 的六成;華為的策略是用規模與互連(SuperPoD、CloudMatrix 384)補單卡不足,代價是犧牲功耗與機櫃密度,當然中國電費平土地多,看起來不是問題,但是其實限制了集叢的規模,現實是單個數據中心不可能在耗電和面積上,無限量的擴張。DeepSeek 的 V4 在 2026 年 4 月發布,主要仍以 Nvidia 芯片訓練;下一代轉用 Ascend 計劃見報,但能否在萬卡規模穩定完成前沿訓練,仍待驗證。
這會否終結中國的前沿模型?
短期內,最受打擊的是「靠海外算力做前沿訓練」的公司:要麼排隊申請許可(審批是逐案審查,沒有保證),要麼把訓練搬回國內,接受較慢、較貴、較不穩定算力。這會拉長訓練周期,令模型迭代由「每季一代」變成「每半年一代」,屆時已是明日黃花。
「終結」言過其實。中國仍有存量芯片、有走私渠道(SemiAnalysis 估計逾 1.5GW 受限制晶片最終流入中國),不過上述限制與黃仁勳下台,不約而同發生,究意是巧合還是預謀,耐人尋味。不過,客觀影響是中國科技公司,殺個措手不及,股價大幅下降。由於美國民主黨控制了參眾兩院,未來中國科技公司的日子,肯定更不好過。
雖然有國產替代,也有算法與工程效率的空間——DeepSeek 過去就證明,算力受限下仍可做出有競爭力的模型。真正的約束不是「有沒有芯片」,而是「能否在有限算力下,持續做出前沿模型」。這是一場效率的長期競賽,不是一刀切的判決。對香港的實際影響
香港屬 D:5,意味著本地數據中心若向內地企業提供任何大規模算力,同樣要申請美國許可。對本地雲服務商、數據中心營運商與企業採購而言,合規責任由「芯片進口」延伸到「客戶是誰、算力給誰」,只要用的是美國晶片,仍逃避不了合規。跨國企業在香港設置區域 AI 樞紐時,亦要把客戶總部所在地,納入盡職審查。