Google DeepMind 在 11 月 11 日發布 AlphaGenome 2。這個模型把基因變異影響的預測,由組織平均收窄到單一細胞類型與細胞狀態,解決基因研究長期以來的「模糊視野」問題,精準看到同一個基因變異在特定細胞的真實破壞力。
過去的模型只能看整個器官或組織的「平均值」,往往會把關鍵疾病的致病訊號稀釋掉。
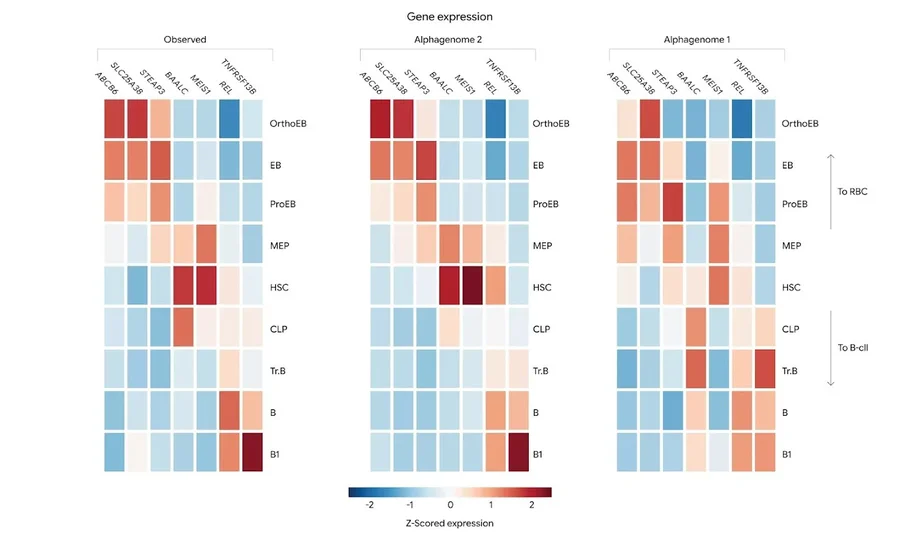
差別為何重要:同一段 DNA,心肌細胞與免疫細胞裡讀法不同。舊一代模型看的是組織平均,容易漏掉只在某種細胞裡作惡的變異。AlphaGenome 2 針對的正是這個缺口,把「哪一種細胞」由背景假設變成可以計算的輸入。
人體約 98% 的 DNA 不直接編碼蛋白質,大部分與疾病相關的變異就落在這些區域。全基因組關聯研究(GWAS)可以指出一段與疾病有關的 DNA,但往往說不出三件事:哪一個字母出錯、影響哪個基因、在什麼細胞裡起作用。AlphaGenome 2 主要處理第三件事,並把前兩件事的線索一併連起來。
AlphaGenome 2 如果能夠精準鎖定「特定細胞在特定狀態下的致病基因開關」,這將徹底改變未來尋找「生物標記(Biomarkers)」與「藥物靶點(Drug Targets)」的遊戲規則,研發變得更精準、副作用更低。另外,AlphaGenome 2 可以幫助免疫療法(如 PD-1/PD-L1 抑制劑、CAR-T 細胞療法)解決同樣的藥物,對某些病人有效,對其他病人卻完全無效,甚至引發嚴重免疫風暴的難題。
模型即日起透過 AlphaGenome API 開放給非商業研究使用;商業研究以私人預覽形式提供。DeepMind 公告表明:AlphaGenome 與 AlphaGenome 2 僅供研究用途,未經臨床或診斷驗證。
同一段 DNA,為何有不同讀法
每種細胞都帶著同一份 DNA 藍本,但不同細胞類型與狀態會開關不同基因,以完成自己的工作。早期實驗技術必須把整塊組織「磨碎」才能測量,這直接導致所有細胞的訊號混在一起。心臟肌肉細胞與正在對抗感染的免疫細胞,就是兩套不同的開關組合。這也是為何把組織打碎混在一起測量,會把只在少數細胞裡發生的變化平均掉。
早期基因定序與表觀遺傳學的測量技術( Bulk Sequencing,也稱總體定序)靈敏度不夠高,無法偵測單一顆細胞裡微弱的分子訊號。隨著全球累積超過一億個高品質單細胞數據,加上 DeepMind 設計多模態神經網絡,AI 能過濾掉單細胞測量雜訊,不需要真實磨碎組織的情況下,直接透過演算法精準模擬出「同一段 DNA ,單一心肌細胞或免疫細胞中究竟是如何被讀取的」。
第一代 AlphaGenome 用一條百萬字母長的 DNA 序列,同時輸出數千個實驗的預測結果。這種並行做法效率高,卻把模型容量攤薄,難以捕捉相近細胞類型之間的細微差異。
AlphaGenome 2 改用條件模型(conditional model):每次只預測一個「條件」——一個組織、一種細胞類型或一種細胞狀態,並在架構的每個階段都把這個條件作為輸入。同一段 DNA 在不同細胞裡如何被閱讀,因此成為模型學習對象。DeepMind 早年以 AlphaFold 2 預測蛋白質結構,把深度學習帶進結構生物學;其後開源的 AlphaFold 2 已成為實驗室常用工具;AlphaGenome 系列則把同樣的思路,放到 DNA 的調控層。
改為條件式之後,模型還可以做跨模態插補:只要輸入一種測量結果,例如單細胞基因活性,就可以預測未測量的性質,例如染色質可及性。研究人員因此可以先判斷下一個實驗值得做什麼,而不是把整組實驗都做一次。
訓練數據與使用方式
DeepMind 表示,AlphaGenome 2 同時用大量與單細胞數據訓練,涉及人類與小鼠樣本。官方有兩個講法:超過 1 億個單細胞數據、涵蓋 68 個組織;另一處則寫超過 1.07 億個單細胞數據。《Nature》報道補充,模型訓練時覆蓋 637 種人類細胞類型與 311 種小鼠細胞類型。本文以 DeepMind 公告為準。
如何使用AlphaGenome 2 有兩種方法。第一是從參考目錄挑選細胞類型或組織作為條件。第二是上載自己的單細胞 RNA 測序數據,由模型的細胞編碼器即時轉成細胞狀態表示,毋須重新訓練。DeepMind 表示每次最多可用 256 個細胞;甚至「數十個細胞」已足以適應新的細胞狀態。
輸出方面,AlphaGenome 2 保留第一代的核心讀數:基因表達、組蛋白修飾、染色質可及性,另外新增 DNA 甲基化。
關鍵數字:找到近兩倍的因果變異
DeepMind 用 TenK10K 數據集測試。數據集是 28 種原代免疫細胞類型的單細胞圖譜。
結果是:AlphaGenome 2 找到的因果變異比例為 30%,原版 AlphaGenome 在單細胞數據上微調後為 16%;效應方向預測為 43% 對 23%。論文列出整體指標:TenK10K 單細胞 eQTL 因果預測 AUPRC 為 0.76,對比 0.72,以及另一專門工具 Scooby 的 0.69;效應方向 AUC 為 0.85,對比 0.79。
換成日常說法:同一份變異清單,舊模型只能挑出約六分之一的真正因果變異,新模型挑出接近三分之一。比例上仍不高,但對於要在成千上萬個候選變異裡排優先次序的研究人員,這個差距直接決定實驗室,要先做哪幾個實驗,省回不少資源。
炎症性腸病:一個被漏掉的開關
2024 年《Nature》刊登一項研究,找出炎症性腸病(IBD)的一個驅動因素:一個位於「基因沙漠」的遠端調控開關變異,令腸道巨噬細胞裡的 ETS2 基因過度激活。這段 DNA 距離蛋白編碼區很遠,靠傳統方法很難追。
DeepMind 表示,AlphaGenome 2 在腸道多種免疫細胞上做預測,計算上重現了這個發現:模型挑出同一個因果變異,並顯示它只在腸道巨噬細胞裡加強 ETS2,其他細胞類型與基因大致不受影響。
該研究主持人、弗朗西斯·克里克研究所免疫學家 James Lee 對《Nature》說:「他們 30 分鐘就得出答案,而我們用了一年半的實驗。」。
不過,模型沒有取代濕實驗,只是把「先做哪個實驗」的判斷提前。
未見過的細胞狀態:疫苗激活後的 T 細胞
條件模型的另一個用途,是處理訓練時沒有見過的狀態。DeepMind 舉了一個例子:給予一份 COVID-19 mRNA 疫苗研究的單細胞數據,AlphaGenome 2 能分辨疫苗激活的免疫 T 細胞與靜止的 T 細胞。
模型同時顯示,一個與重症 COVID-19 相關的變異,細胞處於激活狀態時對基因活動的干擾更強;這種效應在未激活的細胞裡看不到。這正是組織平均模型最容易漏掉的情況:細胞狀態改變,同一個變異的後果也改變。
把 GWAS 信號接到細胞上
GWAS 找到的是與疾病相關的 DNA 區段,但要走到藥物靶點,還要知道哪個變異、哪個基因、哪種細胞。DeepMind 為此預先計算了一批結果,研究人員不必自己跑大規模運算。
團隊在數百個人類細胞與組織條件下,為近 700 萬個與性狀相關及常見的變異建立預測分數,並把增強子-基因連結由實驗室細胞系擴展到原代人體細胞,例如支援和保護神經元的腦星形膠質細胞。在模型有信心時亦會預測變異是把基因活動調高還是調低,這是判斷基因如何參與疾病的關鍵線索。
這一點與基因編輯療法的方向相呼應。以 CRISPR 一針降壞膽固醇逾五成:CTX310 一年數據揭示基因編輯治療潛力 為例,要改動的鹼基已相對清楚;更難的一步,往往是確定哪一種細胞才是要處理的對象,以及某個調控變異在該細胞裡的方向。
限制:高精確度下仍只找到少數因果變異
論文的討論章節把限制寫得很清楚,以下為重點:
- 在高精確度之下,模型只找回少數已精細定位的 eQTL 與推定因果的 GWAS 變異。
- 即使在相關細胞狀態,模型仍可能低估因果變異效應,尤其是位於可及染色質以外、非常遠端、或經轉錄後機制作用的變異。
- 召回率偏低,也限制了對個別人之間基因表達差異的預測。
- 瞬態、受刺激與疾病狀態在訓練數據與預先計算的 GWAS 面板中代表性不足;模型仍難分辨神經元亞群等細微狀態。
- 條件表示由觀察性的穩定狀態數據學成,反映的是相關性而非因果關係;模型能否預測基因敲除、過度表達或動態細胞狀態轉換,仍未有答案。
- 每個條件要獨立預測一次,運算量比固定軌道的多任務模型高。
不過模型未經臨床或診斷驗證,不能用於病人診斷或用藥決定。
與 9 月的 AlphaGenome Atlas 不是同一件事
AlphaGenome Atlas 是用第一代 AlphaGenome 預先計算全部約 90 億個單字母變異的影響,數據集約 1PB,並附有 AlphaGenome Variant Impact(AVI)分數。它的用途是查表:不用自己跑模型,就可以比較變異的分子影響。
限制在於細胞類型。《Nature》引述 James Lee 的說法:Atlas 的預測沒有指明變異在哪種細胞起作用,「不能預測細胞類型特異性,對我們用處不大」。
AlphaGenome 2 是模型的更新,不是 Atlas 的替代品。兩者可以並用:先用 Atlas 查分數縮小範圍,再用條件模型在特定細胞類型上確認方向與目標基因。
香港基因組計劃如何切入
AlphaGenome 2 以 API 形式提供,非商業研究可以申請使用,運算在 DeepMind 一方執行,結果經 API 回傳。對本地大學與醫院的研究團隊,這意味著不必自建 GPU 集群,也可以在特定細胞類型上做變異評分。
香港已有可用的基因組數據基礎。政府在 2021 年開展香港基因組計劃,涵蓋未能確診病症、遺傳相關癌症,以及與精準醫學有關的個案。有序列與變異清單,並不等於知道變異在哪種細胞起作用;條件模型正好把這一步變成可計算的工作。
實際可做的切入點有三個:用本地病人樣本的單細胞數據作為條件,預測未見過的疾病或治療後狀態;用華南人群的變異清單,檢查模型給出的細胞類型是否合理;把模型輸出的增強子-基因連結,與本地實驗室的 CRISPR 篩選結果對照。
要留意的界線:訓練數據以公開圖譜為主,免疫與血液的覆蓋較好,其他組織與罕見細胞狀態的覆蓋仍不完整。用於本地研究時,模型結果應視為候選假設,而不是結論。
DeedMind論文
- Google DeepMind 公告,2026 年 11 月 11 日:AlphaGenome 2: Deciphering how cells read DNA to better understand disease
- 預印本:AlphaGenome 2(DeepMind 網站 PDF,限制章節)
- 《Nature》新聞報道,2026 年 11 月 11 日:DeepMind's ultra-powerful AI for genome mapping wows scientists
- AlphaGenome API 文件:AlphaGenome 2 模型頁與 Getting started 頁