人工智能浪潮帶動全球算力需求急升。香港特區政府公布首份《五年規劃》,將人工智能(AI)與智算產業列為未來經濟的發展動力,並推出多項配合AI發展的計劃,包括專項基金、基建及科研布局,以及深化「AI+」應用與政務服務。
不過,香港半導體產業基礎薄弱、電力成本高昂,既缺乏訓練大模型所需的GPU,算力亦不足。現時市場焦點集中於GPU、數據中心和大模型訓練,香港在這些領域缺乏競爭優勢,其AI發展前景難免令人懷疑。
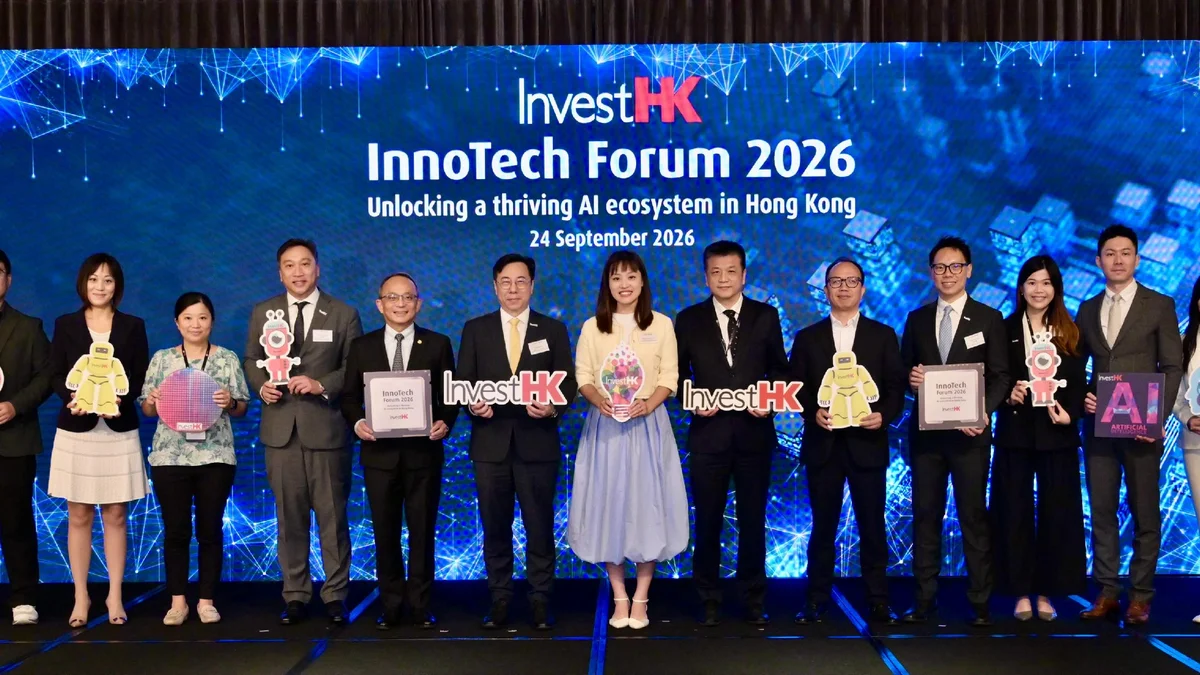
投資推廣署舉辦InnoTech Forum 2026,匯聚逾200名企業高管、科技創新者、投資者及學者,討論香港如何建立涵蓋晶片研發、數據中心、人才、資本以至商業應用的「全棧式」AI生態。香港科技大學副校長(研究及發展)、InnoHK智能晶片與系統研發中心(ACCESS)主任鄭光廷教授在論壇上介紹團隊成果,包括ACCESS的應用—演算法—硬件協同設計工具鏈AC-Copilot,嘗試從差異化方向切入,以軟硬件協同設計加快開發高效、低功耗且可重構的AI推理晶片。
「AI變化非常快,不能只做應用,基礎科研一定要做。我們不僅研發推理晶片,也開發上層的支援軟件。簡單來說,就是如何把別人訓練出來、原本在雲端運作的龐大模型部署到端側,同時保持高準確度、高效能和低功耗,再利用專用晶片實現加速。」鄭光廷表示,ACCESS希望建立涵蓋基礎研究、人才培育、晶片設計與流片,以至技術轉移和創業的完整鏈條,而非停留在發表論文的階段。
「我們希望做到從0到10,建立比較完整的鏈條。ACCESS成立六年多以來,工作大致分為三類:第一是設計工具,第二是商業級流片,第三是前瞻性流片驗證。在推動技術轉移方面,已有六家初創公司,面向具身智能、金融計算等不同應用;這些領域都需要高性能、低功耗的晶片,應用場景相當多。」
香港「AI+」由政策走向產業
論壇舉行前一周,特區政府公布首份《五年規劃》及《施政報告》,提出「AI產業化、產業AI化」,透過科研轉化、算力基建、產業資本及應用場景完善AI生態。
政府計劃啟動100億港元「創科產業引導基金」,投資人工智能與機械人、半導體與智能設備、生命健康科技、數字化轉型及可持續發展等領域,目標是連同市場資金形成至少400億港元規模;同時優化「創科創投基金」,以聯合基金方式吸引私人資本投資策略性科技企業。政府亦宣布向「人工智能資助計劃」注資10億港元。計劃原有規模為30億港元,主要資助大學、研發機構及企業使用數碼港人工智能超算中心的算力;截至2026年6月,已批出逾30個項目,算力資助接近14億港元。
另一項大型部署是沙嶺數據園區。項目由香港潤江智算科技投資、建設及營運,將於2027年起分階段落成,至2030年前後提供18萬PFLOPS算力,相當於目前香港整體算力約36倍,累計投資逾238億港元。園區將為大模型訓練、科研運算及產業應用提供基建,但龐大算力最終仍須面對電力、散熱和成本問題,「如何以更少能源完成更多推理」遂成為重要技術命題。
推理需求爆發 晶片設計追不上模型演進
訓練大模型需要長時間動用大量GPU,香港在算力和訓練人才方面缺乏優勢;但模型一旦落地,每次回答問題、辨識影像或控制機械人,都是一次「推理」(Inference)。當AI代理開始自行規劃任務、連續調用模型及工具,推理次數和Token用量更會倍增。對自動駕駛、機械人、智能眼鏡、手錶及醫療裝置而言,推理更要在裝置端即時完成,不能完全依賴雲端。
鄭光廷指出,AI模型變化速度極快,傳統晶片卻可能需要數年時間設計。ACCESS自2020年成立以來,嘗試把晶片設計「工具化」,提升硬件開發速度,以追上演算法的演進。中心由香港科技大學主導,合作院校包括香港大學、香港中文大學及瑞士洛桑聯邦理工學院,研究涵蓋AI輔助電子設計自動化、記憶體與運算架構、異質整合,以及面向實際應用的硬件加速。
AC-Copilot:把模型直接連到晶片架構
AC-Copilot是一套連接應用、AI演算法和底層硬件的協同設計流程,把神經網絡架構搜尋、模型壓縮、硬件模擬及軟件生成整合於同一工具鏈,支援由PyTorch、ONNX等框架一路走到具體硬件實現;團隊亦利用大型語言模型提升效能估算的準確度。
傳統做法是由演算法團隊先完成模型,再交由硬件工程師設計加速器;軟件與晶片各自優化,待硬件完成時可能已經過時。AC-Copilot則在設計初期同步考慮模型結構、數據流、記憶體層級、運算單元和軟件執行環境,按特定工作負載自動搜尋更合適的架構。換言之,AC-Copilot設計的晶片不像近期由AMD收購的Taalas般,把某個模型「寫死」在晶片上,而是在專用晶片的效率與可升級平台的靈活性之間尋找平衡。
ACCESS公布的測試顯示,由AC-Copilot設計、採用28納米製程及500MHz時脈的AC-Transformer,運算效率高16.3倍,能源效率高7.2倍;計劃中的12納米原型,在同一模型上的能源效率差距更可達19.8倍。
登上「晶片設計奧運」ISSCC
AC-Transformer不只在實驗室跑分。ACCESS以AC-Transformer的28納米商用級測試晶片為基礎撰寫的論文,獲2025年國際固態電路會議(International Solid-State Circuits Conference,ISSCC)接納並發表。ISSCC是全球最具代表性的積體電路會議之一;入選研究通常不只提出架構概念,還須以實際流片及量測結果證明晶片能夠運作。
鄭光廷教授表示,這是香港首次在ISSCC發表AI運算晶片論文,也是中心由設計自動化工具走到實際流片的里程碑。
研究針對自動駕駛及具身智能常用的語義分割模型,處理CNN與Transformer帶來的記憶體存取和運算負擔。晶片的混合注意力處理單元把外部記憶體存取減少22.05倍;跨注意力與卷積層的融合排程令能源效率提升1.45倍;級聯式特徵圖剪枝則達到76.1%的稀疏度,把相關運算量減少6倍,系統級能源效率較最先進設計高3.86至10.91倍。
鄭光廷形容:「ISSCC被稱為晶片技術的奧林匹克,每年NVIDIA、MediaTek、等公司都會在這個會議發表最新晶片。我們在2025年發表香港的AI推理晶片論文,是香港首次在AI運算晶片方面取得這項成果,也是重要的階段性證明,代表技術獲得國際認可。論文獲選為當屆AI加速器範疇亮點論文。」
他又以晶片開發週期說明AC-Copilot的作用:第一枚晶片由架構研究到完成流片約花三年;協同設計流程逐步工具化後,下一代晶片的設計週期可縮短至約六個月。
「第一枚晶片花了三年時間;但有了AC-Copilot,把設計流程工具化後,下一代大約六個月便可以完成。」ISSCC成果亦說明,AC-Copilot已貫通模型分析、架構搜尋、硬件設計、流片、測試以至應用驗證。
可重構設計兼容不同大模型
新一代AC-Transformer-DS面向多模態大模型,能按工具鏈的架構搜尋結果,快速重新配置平行運算維度、記憶體層級等參數;晶片支援逾40項核心指令,並預留可擴展指令框架,以配合新運算或新演算法。ACCESS支援DeepSeek、Llama、Gemma及Qwen等系列語言模型,也涵蓋Stable Diffusion、視覺語言模型、Vision Transformer和傳統卷積神經網絡。
AC-Copilot「領域特定、但可重構」的設計,既不同於通用GPU,也有別於把單一模型權重永久固化於電路上的做法。AC-Copilot可針對常見AI運算——例如矩陣乘法、注意力機制及卷積——作高度優化,同時透過指令、軟件棧及重構能力兼容多種模型。即使模型推出新版本,晶片仍可運行同類演算法。
破解「記憶體牆」成下一階段重點
大型模型推理的瓶頸不只在運算單元。尤其在逐個Token生成的解碼階段,系統需要不斷從記憶體讀取龐大權重;搬運數據所消耗的時間和電力甚至比數學運算本身更高,形成所謂「記憶體牆」,亦是晶片推理時的主要成本。
ACCESS正研究混合ReRAM與SRAM的記憶體內運算、以3D非揮發記憶體實現可重構運算,以及結合近存處理與記憶體內處理的異質架構。核心概念是把運算移近數據,甚至直接在記憶體內完成部分運算,減少數據在處理器與記憶體之間來回搬動。另一研究方向則是以Chiplet及3D IC承載更大模型,透過多晶片切分、互連和記憶體堆疊提升容量與頻寬。
、Taalas與ACCESS:三條破解記憶體牆的路線
全球已有多家公司嘗試繞過傳統GPU的記憶體樽頸,技術路線各有不同。由NVIDIA收購的Cerebras選擇「把晶片做大」:Wafer-Scale Engine直接以整塊晶圓作為一枚處理器,最新WSE-3 Turbo面積達46,225平方毫米,集成4萬億個晶體管及90萬個AI核心,主攻數據中心的大模型訓練和高速推理。晶圓級架構把大量運算、記憶體及互連留在同一系統內,減少GPU叢集跨晶片傳輸的延遲,但需要機架級供電、散熱和專用系統,並不適用於智能眼鏡、汽車或流動裝置等「端側」方案。
AMD收購的Taalas則走向另一極端——「把模型變成晶片」。其Hardcore Model平台把特定模型的數據流與權重直接固化於專用矽晶片,消除傳統記憶體與運算之間的邊界,也毋須使用HBM、先進封裝或液冷。首款HC1以6納米製程把Llama 3.1 8B硬件化;公司宣稱單一用戶的推理速度可達每秒17,000個Token,建造成本低20倍、功耗低10倍。
Taalas的優點是特定模型的速度和能源效率極高,代價則是靈活性:當模型架構或權重大幅改變,便要為模型重新設計及製造晶片。Taalas稱,從收到新模型到完成硬件設計可縮短至約兩個月,以快速定製降低傳統ASIC容易追不上模型更新的風險。AMD收購Taalas後,計劃把相關技術納入AI加速器,與Instinct GPU組成系統級方案。
ACCESS的AC-Copilot則處於兩者之間:既不像Cerebras以晶圓級硬件換取數據中心的極大吞吐量,也不像Taalas把單一模型永久燒錄在晶片上;其方向是利用工具鏈,為一組目標工作負載生成「領域特定、但可重構」的加速器,並以指令集、SDK及執行環境保留模型升級空間。這種折衷未必能在單一模型上達到Taalas的極限速度,也不追求Cerebras的超大規模算力,卻適合產品生命週期較長、需要持續更新模型,並受功耗、面積和即時反應限制的汽車、機械人、醫療及邊緣裝置,切合中國的產業需求。
| 技術路線 | 主要做法 | 強項 | 主要取捨 | 適用場景 |
|---|---|---|---|---|
| Cerebras WSE | 晶圓級處理器,把大量核心、記憶體及互連整合於大型系統 | 大模型訓練與高速推理、減少叢集通訊 | 機架級功耗、散熱及部署成本 | 雲端、科研及大型數據中心 |
| Taalas Hardcore Model | 把指定模型的權重和數據流固化於專用晶片 | 固定模型的極高速度及能源效率 | 模型更新可能需要重新設計及製造晶片 | 高用量、版本穩定的推理服務 |
| ACCESS AC-Copilot | 按工作負載協同設計可重構加速器及軟件棧 | 在效率與模型兼容性之間取得平衡 | 效能取決於目標模型、記憶體及實際設計 | 汽車、機械人、醫療及邊緣AI |
機會不是與GPU巨頭硬碰
沙嶺數據園區補足的是大規模算力;ACCESS發展的則是更貼近裝置端和產業應用的高效推理能力。兩者並非互相取代,而是分處AI供應鏈的不同層次。
香港缺乏先進晶圓製造產能,也難以單憑電價與土地成本,跟其他地區競逐超大型數據中心。然而,香港在大學科研、晶片設計、國際合作、知識產權、金融和應用場景方面仍具組合優勢。若AC-Copilot能進一步縮短設計週期,並把工具鏈、晶片IP、SDK及參考設計輸出予半導體企業、EDA供應商和AI方案商,便有機會在AI晶片價值鏈中建立輕資產但技術含量高的定位。
AI競賽的下一階段,不只是「誰擁有最多GPU」,還包括誰能以更低成本和功耗產生更多有效Token,並讓模型安全、即時地部署到汽車、機械人、醫療儀器和各類邊緣裝置。ACCESS正嘗試把香港的科研優勢,轉化為這一輪推理經濟中的籌碼。