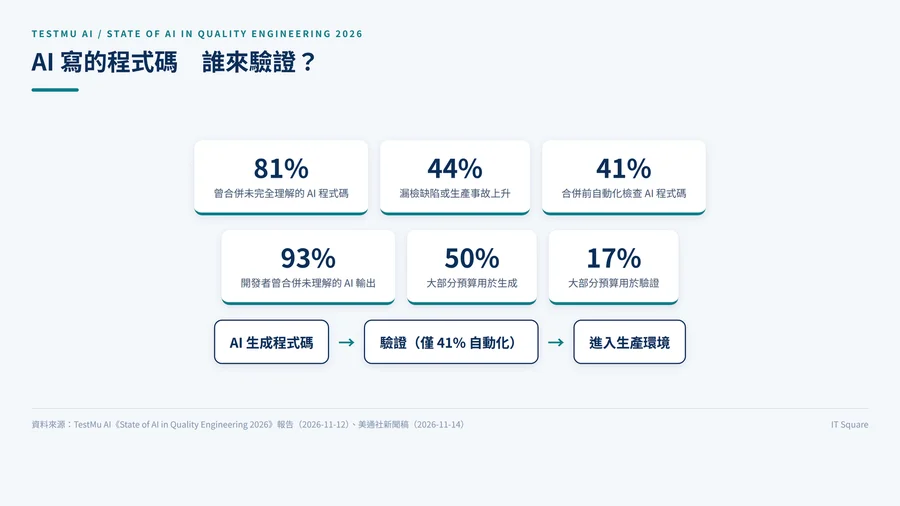
代理式 AI 品質工程平台 TestMu AI(前身為 LambdaTest)於 2026 年 11 月 14 日發佈《State of AI in Quality Engineering 2026》報告。報告發現,81% 的軟件團隊曾合併自己未完全理解的 AI 生成程式碼或測試;隨著 AI 編寫的程式碼增加,44% 的團隊表示漏檢缺陷或生產環境事故有所上升。TestMu AI 表示,97% 的受訪團隊目前已在測試中使用 AI 或計劃採用 AI。
報告由 TestMu AI 委託進行,調查時間為 2026 年 7 月底至 10 月初,對象為測試人員、開發者及品質保證領袖,樣本來自 TestMu AI 的全球社群。報告頁面列明於 2026 年 11 月 12 日發佈,是 2023 年《Future of Quality Assurance》報告之後的 2026 年版。
驗證工作未跟上 AI 生成速度
報告的核心發現是「驗證缺口」。只有 41% 的團隊會在合併前對 AI 編寫的程式碼進行自動化檢查;大多數團隊依賴人工審查(55%),或在程式碼編寫完成後交由品質保證(QA)團隊處理(51%)。
報告同時比較了持續整合(CI)測試與缺陷的關係:未有獨立執行 CI 測試的團隊中,49% 出現漏檢缺陷增加的情況;有執行這類測試的團隊,比例為 38%。報告亦指出,40% 的團隊現時已有超過一半的生產環境程式碼由 AI 編寫。開發者層面的數字更高,93% 的開發者表示已合併自己未完全理解的 AI 輸出。
用一個模型評判另一個模型
部分團隊採用「LLM-as-a-judge」方式,以一個模型為另一個模型的輸出評分。報告發現,使用這種方式的團隊中,29% 經常合併自己並不理解的 AI 輸出,約為其他團隊(15%)的兩倍。
對於 AI 生成的測試,報告指出「大致正確,但仍有偏差」這類情況所佔比例的中位數為 65%。報告的描述是:AI 現時已負責編寫大量程式碼及測試,但大多數團隊仍在生成後交由人員核查,或依靠另一個 AI 模型驗證。
AI 代理與預算分配的落差
在 AI 代理方面,77% 的團隊正在開發需要測試的 AI 代理,但其中 37% 沒有系統化的評估方法,只有 28% 會讓用戶刻意嘗試令代理出錯,以測試其表現。
預算分配同樣偏向生成而非驗證:50% 的團隊將大部分 AI 測試預算用於生成 AI 輸出,將大部分預算用於驗證輸出的團隊只有 17%。此外,只有 13% 的團隊備有針對 AI 錯誤的事故應變計劃。
TestMu AI 的看法
TestMu AI 聯合創辦人兼行政總裁 Asad Khan 表示:「軟件團隊現時依賴 AI 編寫程式碼、生成測試,亦愈來愈依賴 AI 判斷程式碼及測試是否已準備好推出。然而,驗證工作並未跟上這個轉變。我們認為,AI 產生的任何輸出,都應在合併前及每次變更時,由獨立於生成模型的系統進行驗證。遵循這項原則的受訪團隊,進入生產環境的缺陷較少。」
TestMu AI 表示,平台透過逾 5,000 個瀏覽器及逾 50,000 部真實裝置,為網頁及流動應用程式執行由 AI 代理驅動的測試,並涵蓋聊天、語音、互動語音應答(IVR)、影片及圖像代理。上述平台規模數字為該公司自述。