宣布其最新前沿模型 Gemini 4 Carbon 已全面開放予開發者、企業、科學家及消費者使用。據 Google 官方部落格指出,Carbon 是該公司目前最強的模型,在網絡安全能力以及跨複雜知識工作、軟件工程和科學推理的長程代理工作流(long-horizon agentic workflows)中展現出前沿性能。此次發布不僅標誌著模型能力的進一步突破,更透過同步預覽 Google Antigravity 中的 /swarm 功能,展示了多智能體協同處理複雜任務的新範式。
定價策略與開放範圍:與 Argon 持平的入門價格
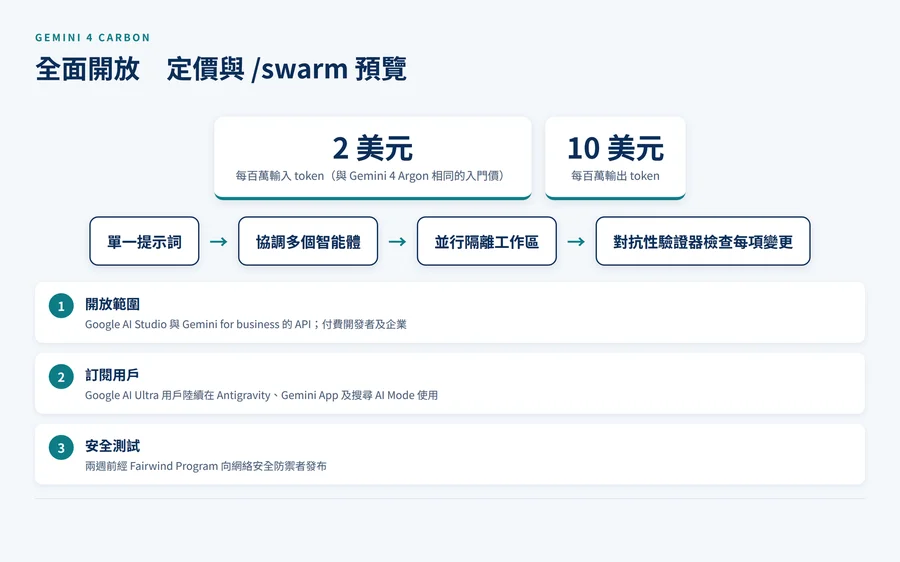
在商業部署方面,Gemini 4 Carbon 透過 Google AI Studio 和 Gemini for business 的 API 向所有付費開發者和企業開放。據新聞稿指出,其定價策略與前代模型 Gemini 4 Argon 保持一致,維持相同的入門價格:每百萬輸入 token 收費 2 美元,每百萬輸出 token 收費 10 美元。此外,該模型亦正在向所有 Google AI Ultra 訂閱用戶推出,覆蓋範圍包括 Google Antigravity、Gemini 應用程式以及搜尋引擎中的 AI Mode。對於香港企業而言,這種透明且與前代持平的定價結構,降低了嘗試前沿模型的門檻,使得在生產環境中測試高複雜度 AI 任務變得更加可行。
與 Gemini 4 Argon 有何分別?定位與性能差異
兩週前,Google 曾透過 Fairwind Program 向一組網絡安全防禦者發布 Carbon。與近期推出的 Gemini 4 Argon 相比,Carbon 將前沿性能推向了更進一步。Argon 仍然是大多數軟件工程和知識工作的理想選擇,而 Carbon 則專為測試模型智能極限的任務而設計,例如複雜的多步驟編程與除錯,以及開放式的科學研究與發現。Carbon 會使用比 Argon 更多的 token 來進行徹底探索、深度推理並運行擴展驗證循環。在獨立基準測試中,Carbon 在 CursorBench 4.0、Perplexity 的 WANDR 以及 Zapier 的 AutomationBench 上均排名第一,且與次佳外部模型相比,每項任務的成本降低了超過 2 倍。本站早前報道過 Gemini 4 Argon 推出 Vals Index 居首但獨立評測指編程非最強,當時市場關注點集中在 Argon 的編程能力,而此次 Carbon 的發布則進一步強化了 Google 在高難度推理任務上的優勢。
/swarm 預覽:多智能體協調的實際應用
為了讓 Carbon 的能力應用於更大規模和更複雜的項目,Google 在 Google Antigravity 中預覽了 /swarm 功能。該功能將單一提示詞轉化為一個可實時追蹤的協調智能體團隊。開發者可以將 Carbon 分配給需要最深層推理的角色,如架構設計、協調和審計,同時將其與更快、更輕量級的智能體配對,在並行隔離的工作區中運行,並由對抗性驗證器測試每一項變更。據 Google 展示的案例,一個由 Gemini 4 Carbon 智能體組成的團隊,僅憑單一提示詞,便將歷史照片和工程圖板轉化為一個互動式 Three.js 3D 展覽,展示埃菲爾鐵塔 1887 至 1889 年的建造過程。另一案例中,Google 用 7 份公開的市議會規劃 PDF(提取出 206 個工程圖視圖),以單一提示詞讓多智能體 Carbon 團隊經過 10 個夜間循環,構建出約 90.6 萬個三角形的互動式 Three.js 重建模型,還原 Google 的 Platform 37 辦公室。上述案例由 Google 在官方部落格自行發布。
對香港企業與開發者的意義
對於香港的科技生態系統而言,Gemini 4 Carbon 的全面開放意味著企業可以更低成本接觸到具備前沿網絡安全與複雜推理能力的 AI 模型。在金融科技與數據分析領域,Carbon 結合了前沿視覺理解、推理和徹底檢索,能夠跨大量密集文檔和數據綜合出有依據的見解,並遵循嚴格的模式與格式生成精緻且精確的電子表格、演示文稿和報告。據 Google 與 Artificial Analysis 合作推出的新基準測試 Multimodal Knowledge Agent (MKA) 顯示,Carbon 排名第二,且平均每項任務成本比表現最佳的模型低超過 6 倍。此外,在預發布評估中,Carbon 在 Hebbia 的 E2E Financial Agentic 評估中匹配了受測最佳模型的深度金融研究表現,並在 Balyasny Asset Management 的 General Financial Intelligence 基準測試中,於 23 個前沿模型配置中位列前茅,涵蓋法律專業知識、代理工具使用與執行、編程與數據工程以及感知與上下文理解。對香港企業而言,官方公布的入門定價與 Argon 相同,是評估是否把高難度推理任務外判給前沿模型時可直接比較的成本基準;至於實際表現,仍需按自身工作流測試。