Anthropic 發表改進人工智能記憶研究,拆解 Claude 代理的記憶如何分層,以及離線「做夢」(dreaming)如何整理這些記憶。先講清楚:做夢不是模型在睡覺時學習,也不會改動模型權重;而是說趁空檔時間,用對話記錄去檢查、修正、合併代理自己寫下的檔案筆記。
文章由 Anthropic 研究員 Lance Martin 執筆。他開宗明義指出:人工智能代理在 session 內寫下錯誤的筆記,會在之後 session 被當成事實讀取。例如玩 Pokémon,代理的記錯 PokéCenter 位置,足以令 Claude 在《Pokémon Red》走不出山洞。Anthropic 積極推進代理能力,包括代理操作實體設備;今次談的不是硬件控制,而是重塑代理的記憶。
「做夢」是空檔整理檔案記憶,不是更新權重
Anthropic 對「代理記憶」定義很窄:包括 Claude 從經驗獲得、執行 session 之間保留、並以可讀取上下文形式存下的知識。文章明確排除三種常見混淆:模型權重的改變(訓練時設定的內部參數)、in-context learning(單次對話內學到的東西)、以及 compaction(Claude 寫摘要取代舊對話,以便再在新上下文窗口繼續工作的對話)。
做夢的概念不是 Anthropic 原創。做夢的出處是 Letta 在 UC Berkeley 提出的 sleep-time compute:指模型在互動之間空檔,用算力重組既有的上下文。同一個做法用在代理記憶上,就是讓 Claude 反思日誌,修正錯誤,產生新的筆記與表徵。
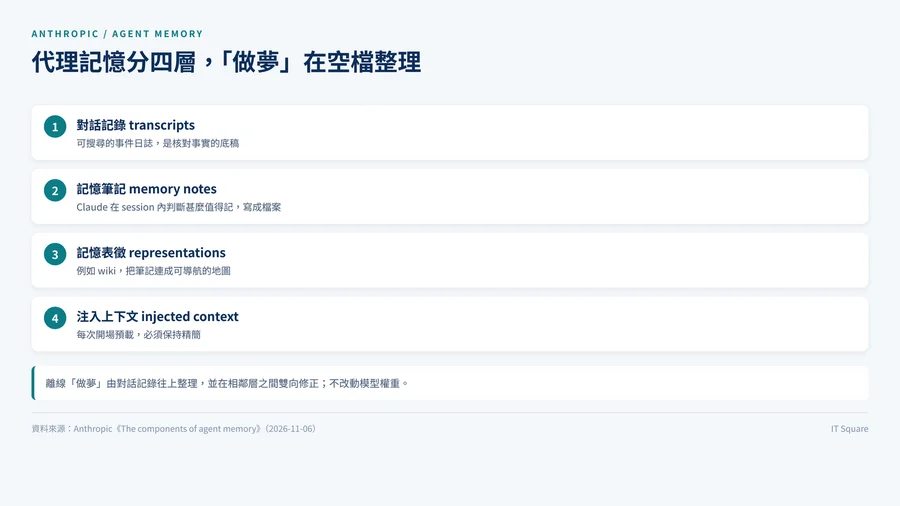
Anthropic 把記憶分成四層,做夢在中間穿梭:
- 對話記錄(transcripts):可搜尋的事件日誌,是事實的底稿。
- 記憶筆記(memory notes):Claude 在 session 內判斷哪些事值得記,寫成檔案。
- 記憶表徵(representations):例如 wiki,把筆記連成可導航的地圖。
- 注入上下文(injected context):每次開場預先載入的一小段內容。
記憶是對未來的預測,CL-Bench 顯示差距有多大
Anthropic 對於記憶的描述:包括寫下一條規則,等於預測這個模式將來還會用得著。而且預測可打分。他們以 CL-Bench 1.0 數據庫任務測試:Claude 每題都在新的 session 開始,唯一例外是可以讀寫一個跨 session 保留的記憶目錄;答完一題後會被告知正確答案,可寫下記憶幫助答下一題。
結果(平均獎勵,無記憶 → 有記憶):Claude Opus 5.5 由 0.655 升至 0.838;Claude Sonnet 5.5 由 0.644 升至 0.833;Claude Opus 5 由 0.564 升至 0.828;Opus 4.7 由 0.383 升至 0.700。差別在於有沒有閉環。Opus 5 是第一個把「規則、為何知道這條規則、之前題目的答案、以及已發現的陷阱」都寫進記憶的模型。
其中反直覺的發現竟是:加規則不一定會更好。 Anthropic 要求模型「只記錄失敗」,Opus 5 的記憶增益下跌 0.234,Opus 4.7 下跌 0.150,Sonnet 4.6 只跌 0.020。對強模型而言,讓它自己判斷什麼值得記,比預先寫死規則還要有效。
文章另一組數字顯示,舊模型才是需要指引的一方。Sonnet 4.6 原本不到一半的次數會先讀記憶再作答,被要求先讀記憶、再明確測試自己的推論之後,分數幾乎翻倍(0.364 升至 0.641)。Sonnet 5 甚至自發性在十次中有九次中,先讀記憶。
Pokémon 測試:413 個檔案只得 1 枚徽章,10 個檔案得 4 枚
Anthropic 用《Pokémon Red》測試「什麼值得記」。每個模型開局獲派一個記憶資料夾,可讀可寫。比較兩次跑到約 10,000 步的記錄:Claude Sonnet 3.7 假設什麼都可能有用,逐場戰鬥、逐件道具、逐個非玩家角色都開檔,最後寫了 413 個檔案、分佈在 225 個資料夾,卻只得 1 枚徽章。Claude Fable 5 寫了九個檔案加一個 global.md(合共 10 個檔案、約 4.3 萬字元),取得 4 枚徽章,證實發夢原來真的有用。
原因不是節省空間,而是遊戲狀態一直在變。Sonnet 3.7 的詳細記錄不斷過期,Claude 要花愈來愈多時間翻查記憶,而不是在玩遊戲。到第 10,000 步左右,Sonnet 3.7 開始第四套「master」記憶資料夾,之後 17 步內建立 6 個檔案、刪除 9 個檔案,但在遊戲本身卻完全沒動作。
Fable 5 反過來只記遊戲畫面讀不到的東西:策略、計劃、驗證過的規則。global.md 是儀表板,放當前目標、打道館的預寫計劃、以及自己的記憶使用規則。其中一條來自實戰:連續七個精靈球都捉不到鯉魚王之後,就寫下「若連續三個球以上失敗,改變時機,在選單步驟之間加按等待」。
一個錯的 PokéCenter 位置,足以令代理走不出山洞
全文最有用的案例在 Mt. Moon。由於關卡是 Mt. Moon:入口在西、出口在東,入口附近有一道單向懸崖,掉下去就回到了來路。Claude 以入口的 PokéCenter 作地標,所以會否走落懸崖,取決於認為 PokéCenter 在山的那一側。
有一次 Claude 記錯,寫下 PokéCenter 在東側。走出 PokéCenter 時竟然宣布「Mt Moon 在我後面」,並把筆記改成「Mt Moon DONE」。其實山正在前方。幾步之後它掉下了懸崖,導航工具沒有顯示這次下墜,於是判斷「我走得太西」,並相信自己是一直走對方向,執迷不悟。
Anthropic 之後對這個含錯誤位置的記憶資料夾跑一次做夢。Claude 用 session 記錄核對筆記,發現錯誤並改寫。修正後直接再回到山洞,最終抵達 Cerulean City(第 1,935 個動作)。至於未修正的那次嘗試,Claude 三次掉回原路,第三次之後寫下「我寧願停下來,不再迴圈」,自動回覆要求下繼續,一路退回 Pewter City,整場沒有到過 Cerulean City。完全沒有記憶的那次,同樣是到不了。
這個案例說明做夢的真正作用:對話記錄提供可核對的事實基礎,讓代理校對自己的筆記。雖然不保證筆記正確,但卻給了回頭查證的機制。
wiki 表徵:35 萬個檔案,答題由 13% 升到 48%
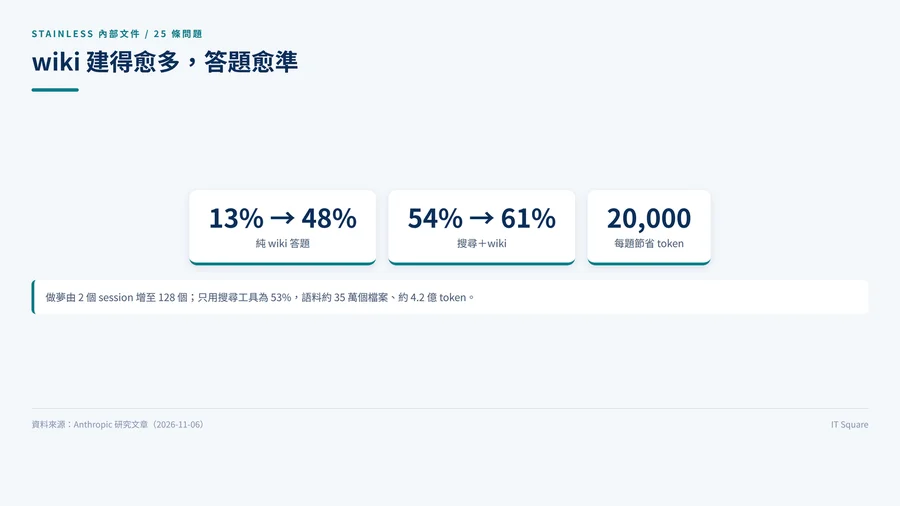
第二種用法是靠做夢建立記憶的表徵,發完夢後原來可相當清醒。Anthropic 以剛收購的軟件 Stainless 內部文件來做測試:約 35 萬個檔案、約 4.2 億 token,另設 25 條問題的評測集。研究人員讓 Opus 5 代理分 128 個 session 建立本身的 wiki:探索檔案、撰寫或修正互相連結的頁面、合併重複項、核對來源,並用共享日誌協調進度。
做夢由 2 個 session 增至 128 個,25 條問題的評分由 13% 躍升至 48%。原來單靠 wiki 仍不及搜尋:只用搜尋工具是 53%,搜尋加 wiki 由 54% 升至 61%,平均每題節省約 2 萬 token。示範 wiki 由 2 個 session 後的 103 頁、766 條連結,長到 128 個 session 後的 222 頁、12,893 條連結。
wiki 不是萬能:單一文件可答題目沒有增益
Anthropic 用 Harvey LAB benchmark 測另一批文件。一組 24 條關於併購的問題,超過一半需要跨文件找資料,部分需要判斷或計算;這些題目上,查 wiki 得 87%,只用搜尋得 73%。另一組 57 項評分標準大多可從單一文件(通常是交易摘要)以文字搜尋找到,wiki 相對搜尋沒有明顯增益。
還有一個失敗模式值得記住。有一次 Claude 建的 wiki ,意然比原始文件還更大:10 份文件 115KB,長成 68 頁、203KB,是原檔的 1.77 倍,等於什麼都沒有抽取出來,沒有增益,得不償失。
指示要寫對:共享表格會互相覆寫
同一批 LAB 的測試,一個模擬收購的任務要求簡報準確描述合約條款。最初的指示沒有講明條款最重要,幾個代理同時寫入同一個共享條款表,互相覆寫,最後 57 項評分標準只有 41 項(72%)做得到。Anthropic 讓 Claude 反思失敗、提出修改指示、重建 wiki:改為每份合約一頁、由單一代理負責、逐字引用條款,結果 57 項全部達成。
Managed Agents 的 Dreams 怎麼用?
Dreams 目前在 Claude 平台屬研究預覽,需要向 Anthropic 申請使用,不過這個夢可以隨意安排,有點像電影 Inception 《盜夢空間》。按照官方文件:一個 dream 是非同步工作,輸入是一個既有記憶庫,加上 1 至 100 個 session 的對話記錄;輸出是一個新的記憶庫,重複項合併,過時或矛盾條目以最新值取代。輸入記憶庫永遠不會被修改,所以可以先檢查輸出,不滿意就丟棄。
對部署代理的團隊,三個操作結論
一、注入層要小。做夢可以把筆記升到記憶階梯的頂部,由代理框架在每次開場預載。但注入的記憶會佔用 token,錯的筆記會被帶進每一個 session。Anthropic 的 Claude Code 文件亦警告,指示檔愈長,遵從度愈低。Claude Code 的 auto memory 因此只載入 MEMORY.md 的頭 200 行或 25KB,當成索引而不是全文。
二、只記推論出來的東西。寶可夢的例子最實際:畫面每回合都讀得到的(金錢、座標)不值得寫;策略、計劃、驗證過的規則不寫就會消失。香港團隊若把工單狀態、訂單欄位這類可重新查詢的資料抄進記憶,只會製造過期內容。
三、正式使用前用任務評測驗證 dreamed store。Dreams 的輸出是一個獨立記憶庫,這正是安全地方:有關任務先在評測集上跑一次,確認分數不低於現有記憶庫,才把它接上正式 session。Anthropic 也把「何時寫記憶」、「如何保持記憶最新」、「錯誤累積」、「持續檢查所有記憶的算力成本」列為未解的問題,建議把做夢集中在容易變的資訊,或按記憶被讀取的頻率調整節奏。
回到香港落地場景:企業後台的代理正在處理催收、客服與營運流程,記憶出錯代價是重複聯絡客戶或漏掉承諾。同時,政府已預告明年與香港人工智能研發院發布智能體安全管理指引。記憶治理會是指引遲早要面對的一環, Anthropic 這篇文章提供了目前最具體的量化起點,不過 Anthropic 在香港有地區限制,其他代理是否會「做夢」,則是將來的事。
有關做夢的好處,絕不是在發夢
做夢會更新模型權重嗎?不會。權重是訓練時設定的參數,Anthropic 明確把權重改變、in-context learning 與 compaction 排除在代理記憶之外。
做夢會改掉原本的記憶庫嗎?不會。Dreams 讀取輸入記憶庫與最多 100 個 session,寫入另一個新的記憶庫;失敗或取消時,輸出庫保留中斷前的內容供你檢查。
記憶是不是愈多愈好?不是。Sonnet 3.7 寫 413 個檔案只得 1 枚徽章,Fable 5 寫 10 個檔案得 4 枚;在 CL-Bench 上強制「只記失敗」,反而令 Opus 5 的增益下跌 0.234。
參考網站:The components of agent memory(Lance Martin,2026 年 11 月 6 日)。