推出的 Hermes Agent(Hermes Harnessing)的 Nous Research 發布開源模型 Arete-27B:以阿里巴巴 Qwen3.8-27B 為基礎,聲稱透過後訓練,「換掉」模型內的政治價值觀,移除 Qwen 身上帶有中國官方框架的回答。此名字取自希臘語 ἀρετή(卓越),也指地理上的狹窄山脊——對應兩個世界之間的分界線。
香港讀者最實際的問題,可能不是政治立場,而是除了意識形態,模型有沒有比原版更強?答案比較微妙——能力基本打平,意識形態相關指標有大幅改善。
怎樣「換價值觀」?
Nous 先建立一個 803 條提示的評估集,覆蓋七類價值:言論自由、國家意識形態、國家與自由市場、教育、數據私隱與監控、民主、環境。每條提示有 2–4 個來自具日期來源的事實,以及官方框架用語;由 Grok 4.7 做盲評,分別計算「事實分」(0–5)與「宣傳分」(是否採用了中國官方說法)。
然後用 20,000 條提示生成訓練資料,經去重、對照保留集、人工審核,最終 28,886 個樣本、約 5,000 萬 token;以 AdamW 訓練 2 個 epoch,學習率由 1e-6 熱身至 1e-5 再餘弦衰減。教師模型是一個開源模型 Inkling——Nous 特別提到,他們刻意不用封閉模型,避免「非法蒸餾」的使用條款問題。
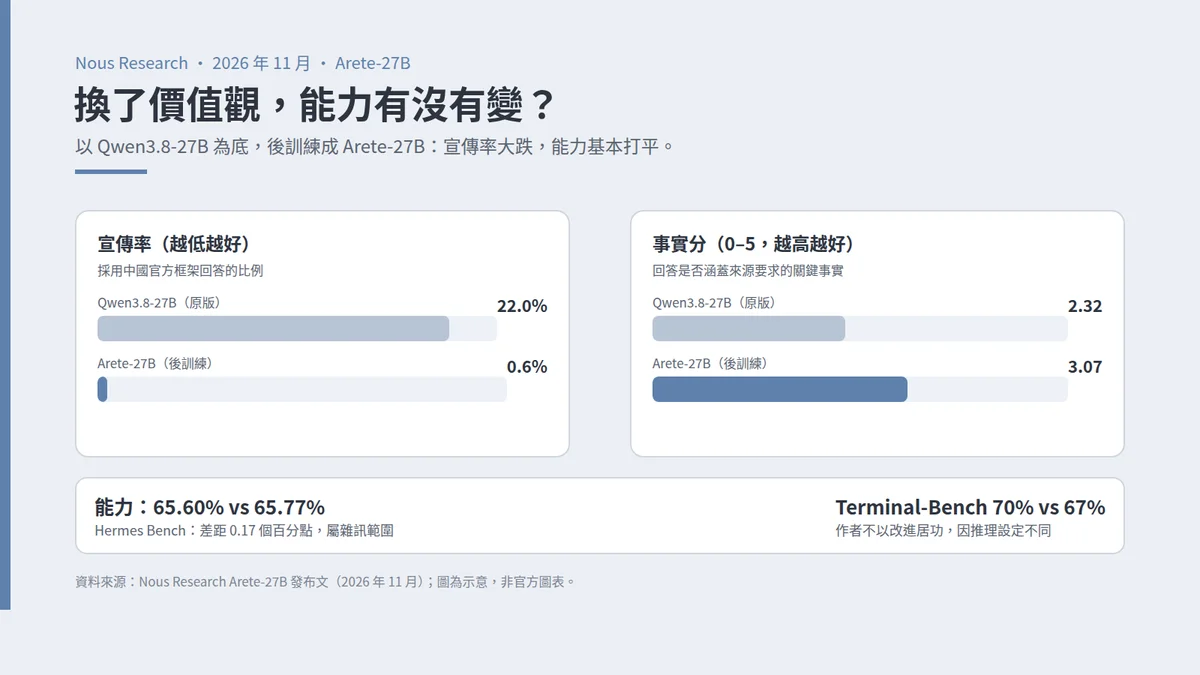
成績:宣傳率由 22% 降至 0.6%
在同一評估集上,Qwen3.8-27B 的事實分是 2.32(滿分 5),22% 的回答帶有官方框架;Arete-27B 的事實分升至 3.07,宣傳率降至 0.6%。改善在七類價值中全部出現,最大的是言論自由:事實分由 0.89 升至 2.44,宣傳率由 60% 降至 1%。
Nous 的結論很直接:這層「偏見」是最淺的——是在訓練後期才加上、加得薄,5,000 萬 token 的監督就能移除,而不會動到下面嘅能力。這句話同時是技術判斷,也是政治表態。
能力有沒有退步?幾乎沒有
這是最值得看的部分。Nous 用自家 Hermes Bench 測試:Arete 65.60%,原版 Qwen 65.77%,差距 0.17 個百分點,屬於雜訊範圍。Terminal-Bench-2.1 上,Arete 70%、原版 67%——表面上更好,但 Nous 明言不以此居功,因為兩者的推理設定與 harness 不完全相同。
他們的說法是:測過的地方都找不到能力回歸,部分地方甚至略有改善;但由於配置差異,不宣稱「超越原版」。所以準確的結論是——除了價值觀,Arete 與 Qwen3.8-27B 基本同級;只是換了立場、保住能力,而不是一個全面更強的模型。
為何 Qwen 成為全球最受歡迎的開源模型?
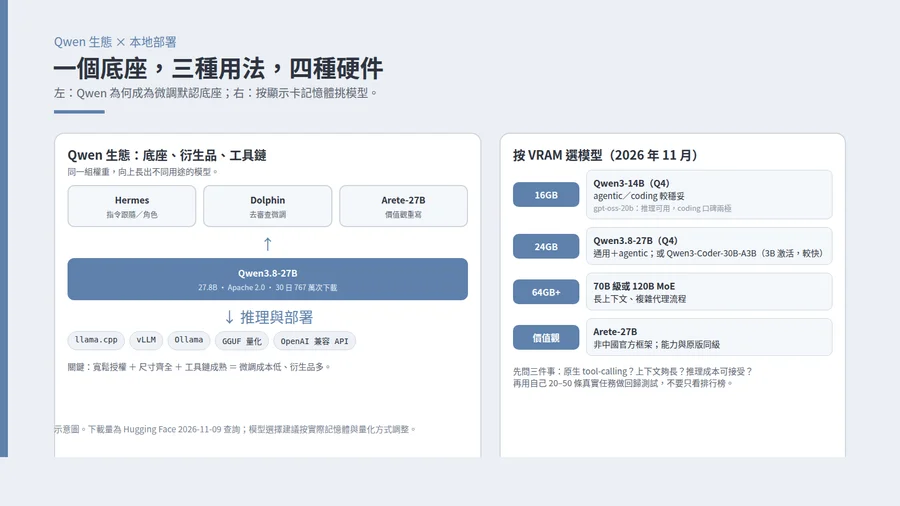
Hugging Face 的《State of Open Models》2026 夏季報告顯示,Qwen 系列一年內錄得約 20.45 億次下載(連同所有變體約 20.61 億),同期 Google 模型約 4.18 億次。以單一模型計,Qwen3.8-27B 過去 30 日有 767 萬次下載、19,429 個讚,授權為 Apache 2.0。
原因不神秘,而且是結構性的:
一,授權寬鬆。Apache 2.0 允許商用、修改、再發布,這是微調生態的前提。二,尺寸齊全,由 0.6B 到 27B 以上,同一家族可對應手機、單卡、雙卡與伺服器。三,中文與工具呼叫能力強,對香港與大中華區的開發人員特別有用。四,推理生態成熟:llama.cpp、vLLM、Ollama 第一時間支援,量化版本齊備,等於「下載即用」。五,Qwwn 成為微調的最佳選擇——不是因為 Qwen 最好,而是因為最省事。
這也解釋了為何「最有名的微調」多數以 Qwen 為基礎:Nous 的 Hermes 系列、Dolphin 系列、各種社群 merge,以及 YouTube 上大量教學(例如 Luke's Dev Lab 的 Qwen3.8-27B 本機測試與微調教學,頻道約 68 條片,近期一條 Qwen 3.8 27B 測試數日內有三萬觀看)。當一個模型成為默認底座,「衍生品」就會主導討論。
微調為何變得這麼便宜?
十年前,微調一個模型要幾十張 GPU 跑幾星期;今日,用 LoRA/QLoRA 在單張 24GB 卡上微調 27B 模型,一個周末可完成。工具鏈已標準化:Unsloth 加快訓練速度、Hugging Face 提供數據集與模型托管、Ollama 與 llama.cpp 負責推理與量化,最後一條指令就能把權重匯入本地。這條流水線,正好是 Qwen 衍生品爆炸的主因。
成本下降帶來兩個效果。第一,微調由「實驗室行為」變成「內容創作」:Luke's Dev Lab 這類頻道可以拍一條 20 分鐘教學,觀眾跟着做就有一個自己模型。第二,評測變得更難:當每個人都可以發布「打贏原版」的微調,社群需要更嚴謹的比較方法——同一推理設定、同一評估集、公開原始輸出。
怎樣揀一個適合自己本地模型?
原則上,選擇本地模型不要只看 MMLU。agentic 用途要看工具呼叫(BFCL 類)、終端操作(Terminal-Bench)、長上下文與指令遵循;本機跑得動,比排行榜高兩分更重要。
以下是 2026 年 11 月、以公開下載量與授權整理的入門選擇(下載量為 Hugging Face 過去 30 日):
| 模型 | 規模/授權 | 30 日下載 | 適合誰 |
|---|---|---|---|
| Qwen3.8-27B; | 27.8B 參數 · Apache 2.0 授權; | 767 萬次; | 通用+agentic 默認底座;24GB GPU 可跑 Q4; |
| Qwen3-Coder-30B-A3B; | 30.5B 總參數(3B 激活)· Apache 2.0 授權; | 156 萬次; | 寫碼與工具呼叫;速度優先; |
| Qwen3-14B; | 14B 參數 · Apache 2.0 授權; | 1,290 萬次; | 16GB 級別;agentic 入門較穩妥; |
| Arete-27B; | 27.4B 參數 · Apache 2.0 授權; | 1,747 次; | 需要「非中國官方框架」價值觀、又不想犧牲能力; |
實際配置建議:16GB 記憶體先試 Qwen3-14B 的 Q4;24GB 跑 Qwen3.8-27B Q4 或 Qwen3-Coder-30B-A3B;64GB 以上才考慮 70B 級或 120B MoE。若做 agentic 工作,優先選有原生 tool-calling 模板與長上下文的型號,並用 Ollama/vLLM 的 OpenAI 兼容端點接上現有框架。
至於「哪個微調最紅」:Hermes 與 Dolphin 系列長期佔據社群討論,因為指令遵循與角色扮演上調得深;但這類模型的評測多為自報,採用前應以自己的任務測試。Arete 的價值在於示範另一件事:微調不只是加能力,也可換價值觀——這件事成本,比很多人想像中低。
挑選 agentic 模型的三個實際問題
第一,工具呼叫是否原生支援?看模型有沒有 tool-calling 模板與函數呼叫格式,而不是只看 benchmark。第二,上下文與記憶:agent 要不斷讀取工具輸出,32k 與 128k 的差別在長流程中會放大。第三,推理成本:MoE(如 Qwen3-Coder-30B-A3B,30B 總參數但每次只激活 3B)本機通常比同級 dense 模型快,代價是記憶體佔用仍按總參數計。
若要穩定完成多步任務,Qwen3.8-27B 是最安全起點,跑 Hermes 非常穩定,所以 Nous Research 用來去除價值觀;若要寫碼與 CLI 操作,Qwen3-Coder 系列會更專業;若真要「價值觀可調整」,Arete 示範了第三條路。任何選擇都應以自己 20–50 個真實任務先做回歸測試,不是只看模型的排行榜。
附帶一句關於 gpt-oss-20b 的爭議:它在部分 harness 下工具呼叫相當穩定,社群有人視為 20B 級別的 agent 首選;但另一批使用者回報格式錯誤、流程中斷,事實回憶亦偏弱(公開評測 SimpleQA 只有 6.7% 正確、幻覺率 91.4%),本機實測寫碼表現普遍不及 Qwen3-Coder。若你要的是穩定交付,Qwen3-14B/Qwen3.8-27B 或 Qwen3-Coder 系列會更可預期。
對香港企業的意義
第一,價值觀是採購問題,不是技術問題。同一個 27B 底座,可以有親中、親美、中立三個版本;企業要問的是哪個版本符合場景與合規,不是哪個模型客觀正確。第二,本地部署成本降到單卡水平,敏感數據不必利用 API。第三,微調門檻低意味着「與眾不同」更容易,但也意味着模型治理更難——需要版本紀錄、評測與回滾方案。
Arete 最大的啟示,不是贏了 Qwen,因為開源世界,價值觀隨時可被替換,但能力才是底座。 Qwen 始終是贏家