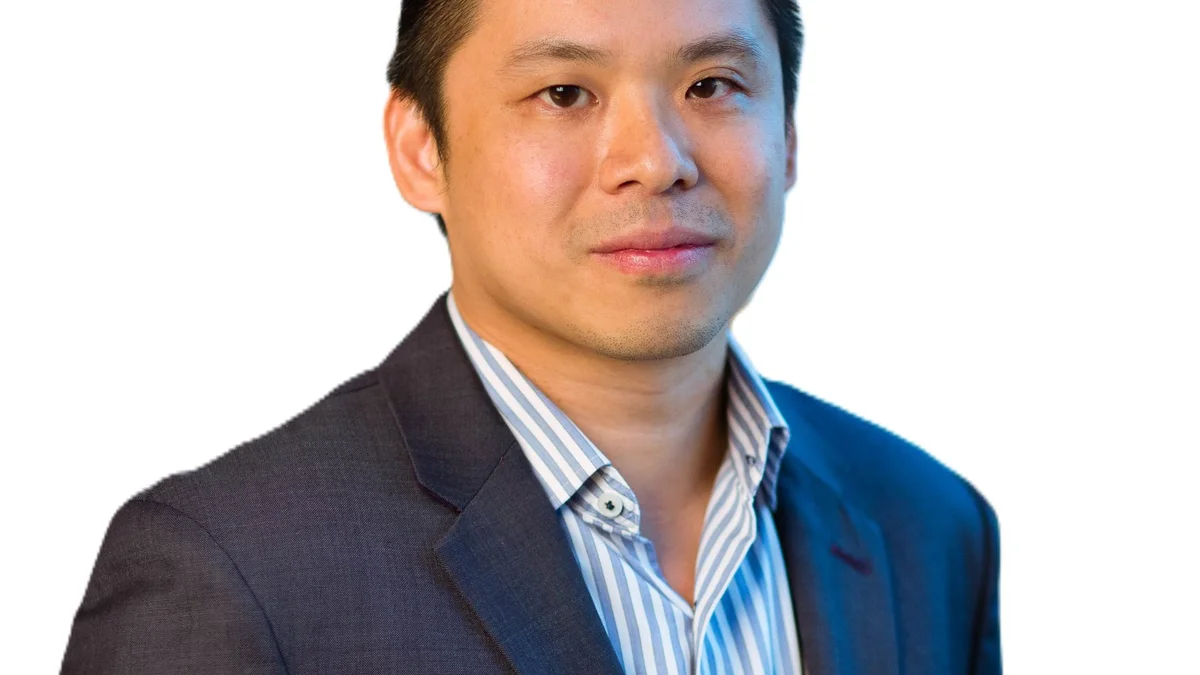
香港企業正加快將人工智能(AI)從實驗室推向正式部署,但背後的網絡基礎架構卻成為隱形瓶頸。HPE 香港及澳門總經理陳家和近日接受 IT Square 專訪時指出,傳統企業網絡以「南北向」流量(即用戶與應用程式之間的連接)為主,但 AI 訓練及高效能運算(HPC)工作負載卻產生大量「東西向」流量——即在 GPU 叢集內部,數以千計的加速器需要以極高頻寬及低延遲互相通訊。若網絡出現擁塞或封包遺失,不僅會拖慢運算速度,更會直接降低昂貴 GPU 的使用率,進而影響 AI 部署的投資回報。
陳家和解釋,這一轉變正推動企業採用專為 AI 優化的網絡架構。以 RDMA(Remote Direct Memory Access,遠端直接記憶體存取)為例,這項技術能讓數據在 GPU 之間直接傳輸,無需經過中央處理器(CPU),從而大幅降低延遲。而 RoCEv2(RDMA over Converged Ethernet,基於融合乙太網的 RDMA)則進一步將 RDMA 擴展至標準乙太網環境,讓企業無需部署專用網絡即可享受高效能傳輸。此外,先進的擁塞管理及動態負載平衡功能也被直接融入網絡,以確保流量傳輸的高效率。與此同時,網絡營運模式也從被動排障轉向「AI 原生」——透過持續遙測、推理及自主修復,逐步實現「自動駕駛」網絡。這意味著網絡不再是運算和儲存規劃後的「補充」,而是 AI 基礎架構的核心組成部分。
《香港大學與德勤中國 2026 企業 AI 應用指數》顯示,僅 4% 受訪港澳企業表示已達到 AI 全面轉型階段,而組織及執行層面的挑戰遠超技術限制。陳家和強調,企業應在 AI 部署初期便將網絡納入整體規劃,而非等到 GPU 安裝後才補救。以 HPE 的 AI Data Center Solution 為例,該方案將運算、網絡、儲存及軟件整合為預先配置、可直接投入正式營運的基礎架構,採用 HPE Juniper Networking QFX 交換機,如適用於推論叢集的 QFX5140 及支援 AMD Helios 縱向擴展架構的 QFX5252,並透過 HPE Networking Data Center Director 進行統一管理。目標是讓 GPU 專注於運算而非等待網絡傳輸,從而提升整體效率。
HPE 於約一年前完成對 的收購,業界關注 HPE Aruba 與 Juniper 在企業網絡、數據中心及 AI 原生網絡領域的整合路徑。陳家和形容這一策略為「交叉融合」(cross-pollination),強調不會強迫客戶全面更換現有系統,而是透過共用的 AI 原生營運模式、硬件支援及代理式功能,實現兩大平台的協同效應。例如,HPE Mist AI 現已支援 HPE Networking CX 交換機產品組合,讓 CX 客戶在選擇 AIOps 平台時享有更大彈性,並可運用 AI 原生可視性、零接觸部署、有線網絡保證,以及 HPE Marvis AI 驅動操作等先進有線網絡功能。與此同時,HPE Aruba Central 現亦提供 HPE Marvis 自動駕駛功能,將自主營運能力延伸至更廣泛的 Aruba 設備環境。
這一整合對香港客戶的直接價值包括:簡化多供應商環境的複雜性、提升端到端可視性,以及加強安全防護。陳家和指出,金融機構、多據點企業及開始建設 AI 基礎架構的機構將受惠於統一的營運體驗——從園區邊緣到數據中心均享有一致的政策、可觀測性及 AI 驅動修復能力。長遠而言,這種融合將為更統一的管理及安全框架奠定基礎,助力企業在混合環境中安全連接日益分散的用戶、應用程式及數據。
傳統網絡自動化僅能加快預設任務的執行,而一般 AIOps(人工智能營運)則提供分析建議,但最終仍需人工決策。陳家和強調,HPE 的「AI 原生」網絡更進一步——將 AI 融入網絡架構及營運模式,使網絡能持續觀察環境、綜合遙測數據進行推理,並自主採取可信賴的操作。這一轉變標誌著網絡從「被動執行」升級為「主動理解及優化」,並逐步實現自我修復。
在實際應用中,這種模式體現為「體驗優先」的服務水平預期(Service Level Expectations,SLE)。HPE Marvis AI 能根據問題對用戶及應用程式的實際影響,優先處理關鍵問題。例如,當 AI 工作負載在 GPU 叢集中出現擁塞時,系統會自動調整流量路由,而非僅發出警報。陳家和提醒,香港企業在採用 AI 原生網絡時需同時應對技術及組織挑戰,包括跨團隊協作、遙測數據完整性,以及逐步建立對 AI 驅動操作的信任。建議從營運痛點最迫切的範疇入手,透過可控範圍的自動化建立信心,再逐步提升自主化程度。
隨著 AI 工作負載分散於數據中心、私有雲、公有雲及邊緣環境,傳統網絡邊界逐漸模糊,保護敏感數據變得更具挑戰。陳家和指出,HPE 的安全原生網絡模式將安全能力直接嵌入網絡架構、晶片及雲端管理層,而非後加的功能。這包括零信任(zero trust)——即根據身分、裝置安全狀態及情境實時執行政策,確保每個連接點都經過驗證;網絡分段(network segmentation)——限制橫向移動,減少攻擊面;以及威脅偵測——結合 HPE Threat Labs 的主動測試,在攻擊發生前發現弱點。此外,HPE 亦將 Juniper 的 SRX 下一代防火牆、SASE(安全存取服務邊緣)、NAC(網絡存取控制)及 SD-WAN 解決方案納入整合方案,提供全面的安全防護。
陳家和舉例,金融機構可透過這種融合,在不同地點及工作負載間維持一致的安全政策,同時簡化營運。對於 AI/HPC 環境,安全需求與傳統企業網絡截然不同——前者需在高頻寬、低延遲的同時,兼顧可視性及威脅偵測,避免成為瓶頸。HPE 的解決方案結合高效能網絡架構及安全原生設計,滿足這一需求。
香港企業在 AI 部署過程中普遍面臨成本、人才及營運壓力。陳家和認為,網絡自動化及智能化是關鍵解決方案。HPE 的自動駕駛網絡策略涵蓋 AI 數據中心、路由及代理式 AIOps,旨在簡化營運並提升效能。透過 HPE Mist 及 HPE Aruba Central 的自主操作功能,團隊能以更少人手介入識別及解決問題,從而降低 AI 大規模部署的營運門檻。例如,當網絡偵測到 GPU 使用率下降時,系統會自動分析是否由網絡擁塞引起,並採取相應措施。這種「主動修復」能力能顯著減少 IT 團隊的干預,讓他們專注於更具策略性的工作。
展望未來,陳家和預計 AI、HPC、邊緣運算及網絡安全將共同改變企業網絡設計原則。核心需求包括:為 AI 工作負載提供可預測的效能、確保分佈式環境的可視性,以及將安全及自動化融入日常營運。香港已具備強勁的 AI 運算容量,下一步是確保網絡、安全及營運能力與之同步發展,協助企業將 AI 從試驗推向正式部署。
陳家和指出,HPE 正透過涵蓋 AI 工廠、數據中心及企業邊緣的整合方案,回應這一需求。例如,HPE Private Cloud AI 解決方案將網絡、運算、儲存及混合雲整合,為企業提供一站式 AI 基礎架構。這種「以網絡支援 AI」(Networks for AI)及「以 AI 賦能網絡」(AI for Networks)的交叉融合策略,不僅能提升 AI 部署的效率,還能降低總體擁有成本(TCO)。
對於香港企業而言,這一轉型尤為關鍵。據《香港大學與德勤中國 2026 企業 AI 應用指數》,大多數企業仍處於 AI 應用的早期階段,網絡基礎架構的升級將成為推動 AI 落地的重要推手。陳家和強調,企業應將網絡視為 AI 基礎架構的策略性支柱,而非後期考慮的「配角」,才能在 AI 時代保持競爭力。HPE 正與香港的金融機構及雲端服務供應商合作,推動 AI Data Center Solution 的落地,以應對 AI 工作負載帶來的網絡挑戰。