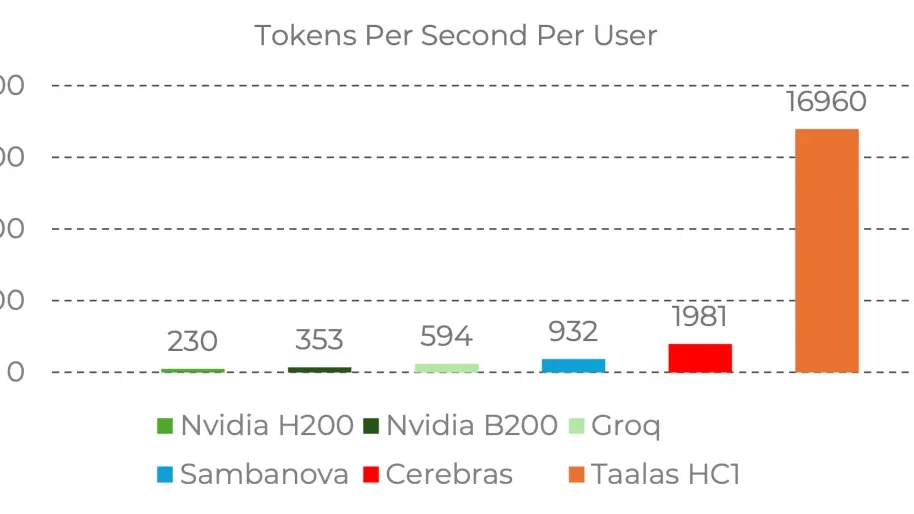
AMD 宣布收購加拿大多倫多初創 Taalas,擴大 AI 推理布局。Taalas 以「模型即硬件(Model‑in‑Silicon)」概念為產品核心,特定 AI 模型直接固定在晶片上,優化數據流、減少計算與記憶體瓶頸,實現優化的推理效能,大幅減少 Token 的生產成本。
傳統晶片執行 AI 推理時,必須不斷從昂貴的外部記憶體(HBM 或 VRAM)「讀取」模型權重(Weights),然後送入晶片核心進行矩陣乘法(MAC)。來回搬運數據的過程,被稱為「記憶體牆(Memory Wall),其實就是 AI 運算的最大成本。
Taalas 則把已經訓練好的權重,晶片製造時,直接透過電路物理連線刻死在晶片內部的 Mask-ROM(光罩唯讀記憶體)。儲存與運算在空間上完全重疊,信號流過去,運算結果就出來,消滅數據搬運的物理極限。這種技術廣義上屬於「存算一體(Processing-in-Memory, PIM / Computing-in-Memory, CIM)」,還是走得最極致的技術路線。
Taalas 技術與 AMD 的全堆疊 AI 平台(full stack AI platform)形成了互補,包括 AI 加速卡(Instinct GPU)、中央處理器(EPYC CPU)、ROCm 軟件(ROCm)、網絡以及 Helios 機架級解決方案。AMD 計劃將 Taalas 的方案納入加速器路線圖,與 AI 加速卡(Instinct GPU)共同開發系統級產品,大大提升 AI 推理市場競爭力。
徹底消除記憶體瓶頸
較早前, 亦完成了 Cerebras 收購。Cerebras 研製大尺寸晶圓級晶片,內建大量靜態隨機存取記憶體(SRAM),保持完全可程式化,能動態載入、執行及切換不同的 AI 模型。
Taalas 則直接在晶片上刻寫單一 AI 模型,透過硬接線專用積體電路(Hardwired ASIC)技術,以突破性速度與效率運作;相較之下,Cerebras 採用可程式化的晶圓級處理器,可同時執行與切換多個模型。Taalas 通過硬接線的 ASIC ,模型權重直接燒錄於硬件,製程更加專屬,無需執行時載入或數據抓取,儲存與運算合而為一,徹底消除記憶體瓶頸,所以輸出 Token 的速度快得驚人。
模型即硬件表現驚人
「模型即硬件」是 Taalas 的核心差異。與通用圖形處理單元(GPU)相比,Taalas 晶片靈活性受限,速度與功耗卻有顯著優勢。根據 Taalas 的數據,HC1 晶片在 Llama 3.1 8B 模型上可達每秒約 16,000 個 token 驚人速度,功耗僅 200–250 瓦。
Taalas 針對高吞吐、固定模型的推理工作負載,屬於專用應用特定積體電路(ASIC)解決方案;相對而言,GPU 適合快速變化多模型堆疊。所以模型達到多高的穩定性,才值得刻入晶片,以往是業界的最大疑慮。
32 B 模型崛起成契機
不過,近來參數介於 8 B 至 32 B 的中小型模型快速崛起,改變了 AI 的經濟效益計算方法。過去,普遍認為 LLM 「越大越好」,且必須不斷升級,現在傾向使用高度優化、蒸餾與專門化的模型,以更小規模大語言模型(LLM)完成複雜推理。
LLM 硬接線至晶片,一度被視為不可行,模型可能半年內過時,難以回收晶片製作成本。隨著採用成熟的 LLM,許多企業寧願選定「足夠好」模型(如 Llama 3.1 8B/32B、Mistral Large、Qwen 32B)執行客服、數據抽取、例行程式編寫等恆常任務,因為綽綽有餘,所以短期內不會更改。30 B 模型取代過去 70 B 或更大 LLM 工作,可以維持運作 2–3 年,足以收回成本,針對高流量、固定工作負載,Taalas 極具吸引力。
以 30 B 模型為例,Taalas 的硬接線晶片佔用極小的晶片面積,可將硬件製造成本降低 10 至 20 倍,同時大幅節省電力。對於每日輸出數十億 token 企業而言,基礎設施支出可從數百萬美元降至數十萬美元。
客製化晶片雨後春筍
軟件模型直接融合至客製化晶片的策略,一般稱為垂直硬件及軟件共同設計(vertical hardware‑software co‑design),在中國已迅速成為技術主流。Z.ai(智譜)推出 GLM-5.3-Flash 模型後,直接在國產硬件叢集上構建客製化推理核心(inference kernels),大幅降低 token 成本;智譜並非唯一採取此技術路線的公司。
DeepSeek 積極打造自有的 AI 推理晶片,已組建專門的晶片設計團隊,開發針對其特色混合專家(Mixture‑of‑Experts,MoE)模型架構優化的客製化專用積體電路(ASIC)。
北京AI初創 ModelBest 聚焦於可在邊緣環境本地執行的較小型大型語言模型(LLM)。此外,壁仞科技(Biren Technology)與百度飛槳(PaddlePaddle)亦在相關領域展開合作。中國在模型即晶片(model‑on‑silicon)領域有優勢,原因是全球最多開源 LLM 產出地。
無論如何,收購 Taalas 為 AMD 在 AI 推理市場提供了新的成長機會,未來有望在特定工作負載下提供比現有 GPU 更高的效能與效率,成為本地 AI 項目中的關鍵技術。